Marcode
Refonte du blog sur le CMS Webflow natif : templates éditoriaux, schéma JSON-LD, publication prête pour l’API.
Le défi
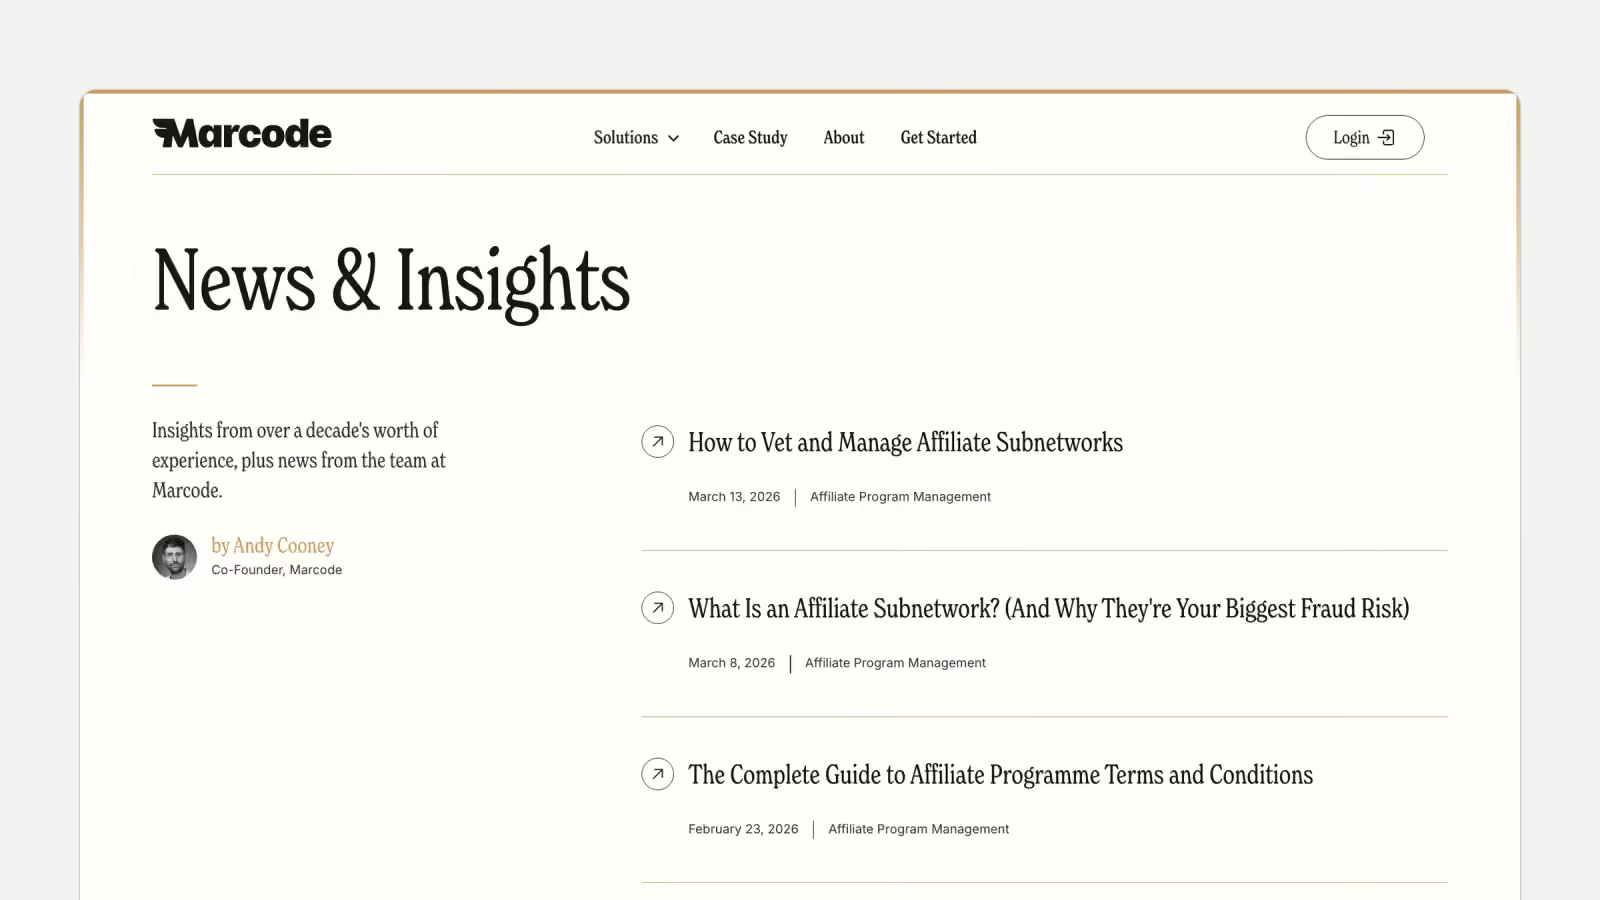
Marcode, une plateforme de détection de la fraude à l’affiliation et de protection de marque, fait tourner son site marketing sur Webflow et publie un hub News and Insights. Quand j’ai repris le projet, ce hub vivait dans un outil de blog tiers intégré plutôt que dans le CMS de Webflow. Le contenu ne pouvait être ni mis en template, ni modélisé, ni publié via l’API Webflow, ce qui bloquait la montée en charge éditoriale.
Il n’y avait pas de collections Authors ni Categories : les signatures et les regroupements par sujet étaient codés en dur. Les articles longs ne portaient aucun schéma Article ni FAQPage, ce qui rendait le contenu en forme de FAQ invisible pour les résultats enrichis. Hors du blog, la hiérarchie des titres était incohérente sur la page d’accueil, les pages de comparaison et les pages d’alternatives, un z-index égaré provoquait un chevauchement de mise en page sur la page d’accueil, et une exploration a fait remonter des liens cassés et des défauts de mise en forme sur les pages marketing.
Ce que j’ai livré
Architecture CMS
Le hub News and Insights a gardé son URL, et la migration n’a nécessité aucune redirection.
Migration du blog vers le CMS Webflow natif avec trois collections : Blog Posts, Authors et Categories, Blog Posts référençant les deux autres. Un template Author piloté par le CMS sert désormais les pages d’auteur sans développer une page par personne.
Template d’article de blog
Un seul template long format avec des liaisons CMS pour le titre, l’auteur, la catégorie, le hero, le corps et les FAQ, plus un style de texte enrichi standardisé pour que titres, espacements, médias et code s’affichent de façon cohérente, quel que soit l’auteur de l’article.
UX éditoriale
Les lecteurs disposent d’une table des matières qui suit la section active, d’articles connexes dans le sujet et de CTA adaptés à la catégorie, sans câblage article par article.
Une table des matières fixe se place sous le bloc auteur et suit la section active pendant le défilement, générée à partir des titres propres à chaque article. Un module d’articles connexes tire cinq articles du CMS, filtrés par catégorie pour que les recommandations restent dans le sujet. Les CTA dépendent de la catégorie : le lien du CTA est porté par la Category plutôt que par l’article, si bien que les articles sur l’affiliation renvoient vers la page de solution contre le détournement d’affiliation et les articles sur le brand bidding vers la protection de marque, sans câblage manuel article par article.
FAQ d’article et schéma FAQPage
Les articles avec FAQ reçoivent une section de questions-réponses et le JSON-LD correspondant ; les articles sans FAQ n’affichent ni l’un ni l’autre.
Chaque article porte son propre champ FAQs, affiché comme une section de questions-réponses. Si un article n’a pas de FAQ, la section est entièrement masquée. Un script par article construit le JSON-LD FAQPage correspondant à partir du contenu de FAQ affiché et l’injecte au chargement, uniquement quand des FAQ existent.
Schéma Article
Le JSON-LD Article est présent sur chaque article de la collection CMS du blog, avec author, datePublished et publisher reliés à des champs CMS pour que le balisage reste synchronisé avec les modifications éditoriales. Le résultat a été contrôlé dans un validateur de schéma et dans l’outil de résultats enrichis de Google avant la passation.
Hygiène SEO et mise en page sur tout le site
Correction de la structure des titres sur la page d’accueil, les pages de comparaison, les pages d’alternatives et les templates du blog : un seul H1 par page et aucun niveau sauté, sans changement visuel. Suppression de l’usage du z-index à l’origine du bug de superposition sur la page d’accueil, et correction des liens cassés et des défauts de mise en forme relevés par une exploration, dans le périmètre de la mission.
Publication prête pour l’API
Livraison des ID de collections et d’items dont l’équipe a besoin pour les écritures programmatiques, avec des consignes pour récupérer les slugs de champs depuis l’API Webflow, afin que les intégrations restent robustes quand les libellés de champs changent.
Les résultats
Le blog tourne désormais entièrement sur le CMS Webflow natif : tous les articles partagent un même template, les pages d’auteur sont pilotées par une collection, et les étiquettes de catégorie comme les signatures s’affichent à partir de références plutôt que d’un balisage codé en dur. Le JSON-LD Article est en ligne sur chaque article de la collection du blog, et le JSON-LD FAQPage s’affiche sur chaque article qui comporte des FAQ. Les pages marketing ont un seul H1 avec une hiérarchie de titres propre. L’équipe peut créer et publier des articles de façon programmatique via l’API Webflow, grâce aux ID et au workflow de slugs de champs fournis à la passation. La mission a duré environ cinq semaines, de début mars à début avril 2026.
Un projet comme celui-ci ?
Commencez par un audit gratuit de votre site, vérifié par moi. Ou réservez trente minutes, votre projet à l’écran : vous repartez avec un plan cadré et un chiffre, que nous travaillions ensemble ou non.